TTThermaltake AI Workstations
Projektberatung
Built in Germany
ROFESSIONELLE AI WORKSTATIONS VON THERMALTAKE

AI Workstations für lokale KI, LLMs & GPU-Workloads. 

Individuell konfigurierte Thermaltake AI Workstations (KI Workstation) für lokale LLMs, RAG, AI Inference, Machine Learning, Deep Learning, Computer Vision, 3D-Rendering und GPU-beschleunigte Anwendungen. In Deutschland konfiguriert, montiert und geprüft.
Thermaltake AX700 Workstation Plattform
NVIDIA GeForce RTX 509032 GB GDDR7 für anspruchsvolle AI- und GPU-Workloads
High RAM Workstations128–512 GB+ RAM für große Modelle und Datensätze
NVMe & HDD StorageSchnelle lokale Datenpfade für AI, RAG und Rendering
Built in GermanyIn Deutschland konfiguriert, montiert und geprüft
Built in Germany

PROFESSIONAL AI WORKSTATIONS 

Unsere Thermaltake AI Workstations werden in Deutschland individuell konfiguriert, montiert und geprüft. Plattform, GPU, CPU, Arbeitsspeicher, NVMe-Storage, Stromversorgung und Thermik werden als integriertes Gesamtsystem auf den jeweiligen AI-, Compute- und Daten-Workload abgestimmt.
Workload SizingPräzise Dimensionierung von GPU, VRAM, CPU, System-RAM, Storage und Plattform anhand von Modellgröße, Datenvolumen, Parallelität und Laufzeitprofil.
Specialist BuildEin spezialisierter Workstation-Techniker verantwortet Komponentenprüfung, Montage, Verkabelung, Systemkonfiguration und finale Freigabe.
ValidationPrüfung und Validierung von Stabilität, Thermik, Firmware, Treibern und Systembasis unter praxisnaher Belastung vor der Auslieferung.
B2B Project SupportProjektunterstützung für individuelle AI-Infrastrukturen, größere Rollouts, Multi-System-Deployments und kundenspezifische Integrationsanforderungen.
ENTERPRISE AI WORKLOADS

AI Workstations für produktive Enterprise-Workloads. 

Von lokalen LLMs und RAG über AI Inference, Machine Learning und Computer Vision bis zu 3D-Rendering und GPU-Compute: Unsere Workstations werden gezielt auf Software-Stack, Datenvolumen, Modellgröße und Performance-Anforderungen ausgelegt.
Local LLM & RAG

Local LLM & RAG

Lokale Sprachmodelle, Retrieval-Augmented Generation und datensensible AI-Workflows mit dedizierter GPU-Leistung, hoher Speicherkapazität und schnellen lokalen Datenpfaden.
Generative AI

Generative AI

Leistungsstarke GPU-Workstations für Bild-, Video- und Content-Generierung mit Stable-Diffusion-, ComfyUI- und weiteren generativen AI-Workflows.

AI Inference

AI Inference

Dedizierte Compute-Ressourcen für reproduzierbare, skalierbare und dauerhaft verfügbare Inference-Workloads mit kontrollierbarer Latenz und Performance.

Machine Learning

Machine Learning

Professionelle Plattformen für Entwicklung, Training, Fine-Tuning, Data Processing und experimentelle Machine-Learning-Workloads.

Computer Vision

Computer Vision

GPU-beschleunigte Workstations für Bildanalyse, Videoanalyse, Preprocessing, Objekterkennung und lokale Modellinferenz.

3D & Rendering

3D & Rendering

High-Performance GPU-Workstations für 3D-Rendering, Simulation, Visualisierung, Content Creation und GPU-beschleunigte Produktions-Workflows.

Reference Platforms

Leistung passend zum Einsatzgebiet.

Drei vorkonfigurierte Ausgangssysteme für unterschiedliche Speicher-, Daten- und Compute-Anforderungen. Jede Konfiguration wird vor Fertigung auf Kompatibilität geprüft.
Core

AI Workstation 5090

Für professionelle Single-GPU AI-, Inference- und Rendering-Workflows.
GPUGeForce RTX 5090 · 32 GB
RAM128 GB
Storage8 TB NVMe + 24 TB HDD
FokusLocal AI · Inference · Content Creation
IDeal für:

Local LLM & RAG

AI Inference

CAD & 3D Rendering

Content Creation

Konfigurieren
Pro

AI Workstation 5090 Pro

Mehr GPU-, RAM- und Storage-Reserven für größere Datensätze und parallele Workflows.
GPUGeForce RTX 5090 · 32 GB
RAM256 GB
Storage2x 8 TB NVMe + 4x 24 TB HDD
FokusRAG · ML · Content Creation
Ideal für

Machine Learning & Deep Learning

Generative AI

größere RAG-Datenbanken

parallele GPU-Workloads

Konfigurieren
Max

AI Workstation 5090 Max

High-capacity Plattform für große Datensätze, hohe Parallelität und Enterprise-Projekte.
GPU2x GeForce RTX 5090 · 32 GB (pro System)
RAM512 GB (pro System)
Storage2x 8 TB NVMe + 8x 24 TB HDD (pro System)
FokusRAG · ML · Generative AI
Ideal für

Enterprise AI

große Datensätze

Multi-Workload-Umgebungen

anspruchsvolle B2B-Projekte

Konfigurieren
Beispielkonfigurationen. Verfügbarkeit und konkrete Komponenten können je nach Projekt, Plattform und Lieferlage angepasst werden.
AI WORKSTATION SIZING GUIDE

Workload-basiertes Sizing für professionelle AI Workstations.

GPU-Leistung, VRAM, CPU, System-RAM, NVMe-Storage und Plattform werden gemeinsam auf Modellgröße, Datenvolumen, Parallelität, Latenzanforderungen und Laufzeitprofil abgestimmt. So entsteht eine Workstation, die zum tatsächlichen AI-Workload passt – nicht nur zur Komponentenliste.
Seitlich wischen →
AI WorkloadGPU & VRAMSystem-RAM & STORAGEEngineering Focus
Local LLM / RAGVRAM häufig entscheidender Faktor bei Modellgröße, Quantisierung und Kontextlänge.Abhängig von Modell, Vektordatenbank, Dokumentbestand und parallelen Sessions.Kontextlänge, Quantisierung, Embeddings, RAG-Datenbasis und gleichzeitige Nutzer berücksichtigen.
AI InferenceDimensionierung nach Modellgröße, Batch Size, Durchsatz und gewünschter Latenz.Abhängig von Modell, Serving-Stack und parallelen Instanzen.Latenz, Tokens pro Sekunde, parallele Nutzer und dauerhafte Verfügbarkeit gemeinsam planen.
Machine Learning & Deep LearningAbhängig von Modellarchitektur, Dataset, Training, Fine-Tuning und Framework.Reserve für Preprocessing, Dataset Caching und parallele Entwicklungsumgebungen einplanen.Datenpipeline, Framework, Trainingstyp, Precision und GPU-Auslastung als Gesamtsystem betrachten.
3D Rendering & Content CreationAbhängig von Szenengröße, Auflösung, Renderer und parallelen Produktions-Workloads.Projektgröße, Cache, Assets und Storage-Durchsatz berücksichtigen.GPU, CPU, Arbeitsspeicher, Cache und NVMe-Storage gemeinsam dimensionieren.
Computer VisionAbhängig von Auflösung, Modellgröße, Batch Size und Video-Streams.Hoher Datenbedarf bei Bild- und Videoanalyse möglich.Preprocessing, Inference, Kamera-Streams und Datenpipeline gemeinsam planen.
Generative AIHoher VRAM-Bedarf je nach Modell, Auflösung und Anzahl paralleler Generierungen.Ausreichende Kapazität für Modelle, Checkpoints, LoRAs, Cache und Projektdaten.Stable Diffusion, ComfyUI, Video-Generierung und lokale Modellverwaltung berücksichtigen.
Die genannten Werte dienen als technische Planungsorientierung. Der tatsächliche Ressourcenbedarf hängt unter anderem von Modellarchitektur, Quantisierung, Kontextlänge, Batch Size, Dataset, Parallelität und Software-Stack ab. Für produktive AI-Projekte empfehlen wir eine workload-basierte Systemauslegung.
<strong>AX700. Flexible Single-System-Plattform für professionelle AI Workstations.</strong>&nbsp;
AX SERIES · PROFESSIONAL AI WORKSTATION PLATFORM

AX700. Flexible Single-System-Plattform für professionelle AI Workstations. 

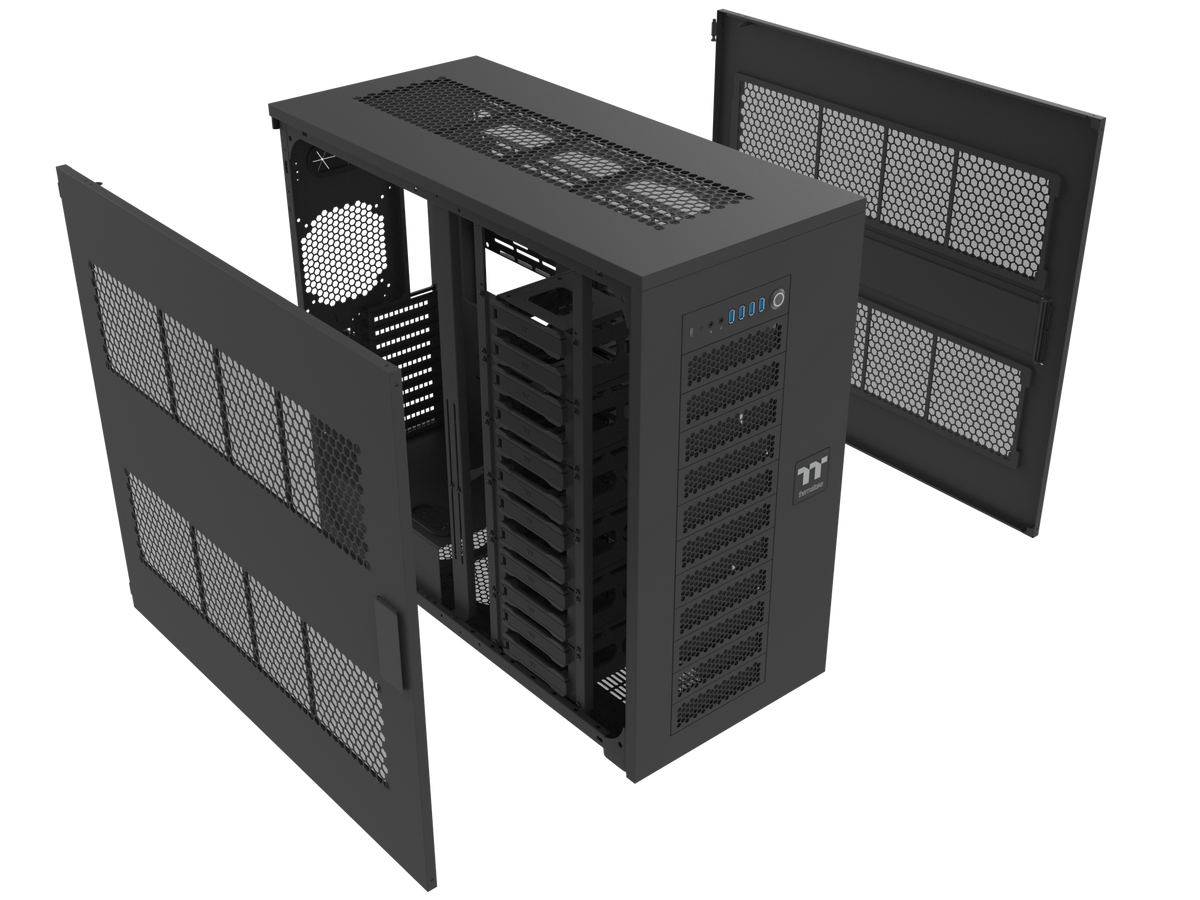
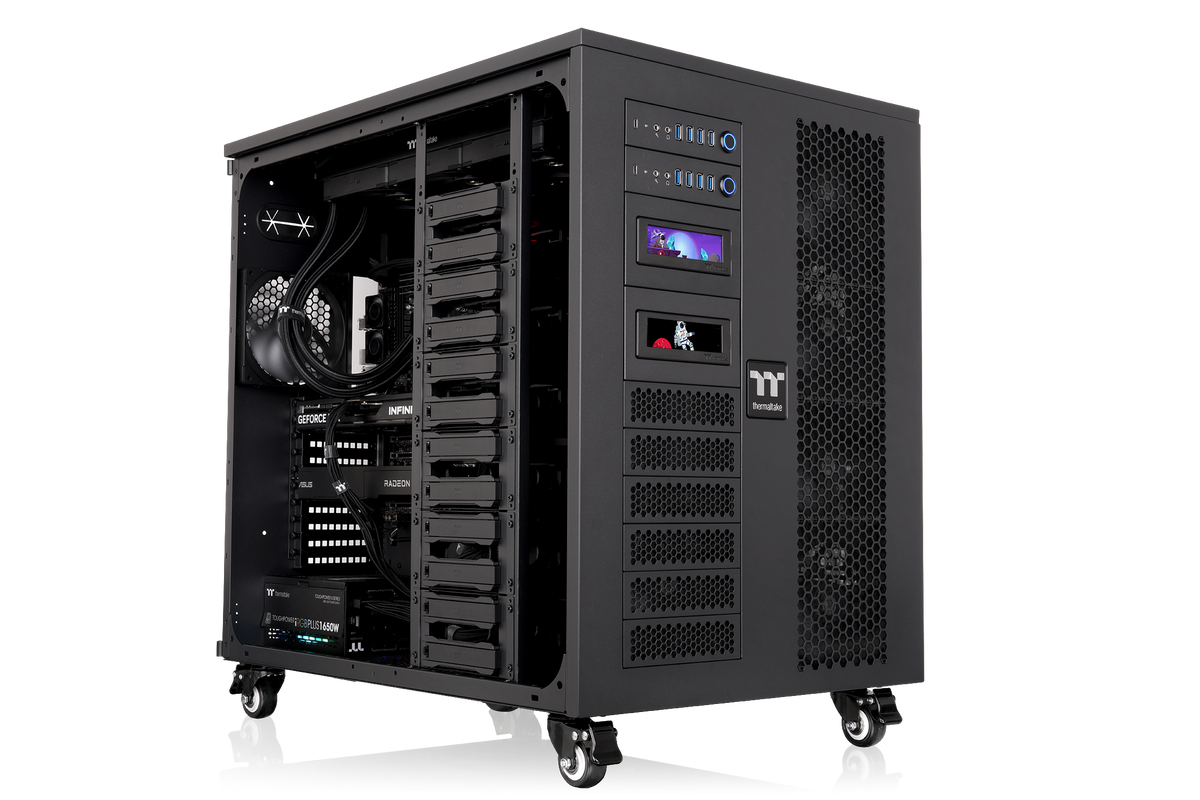
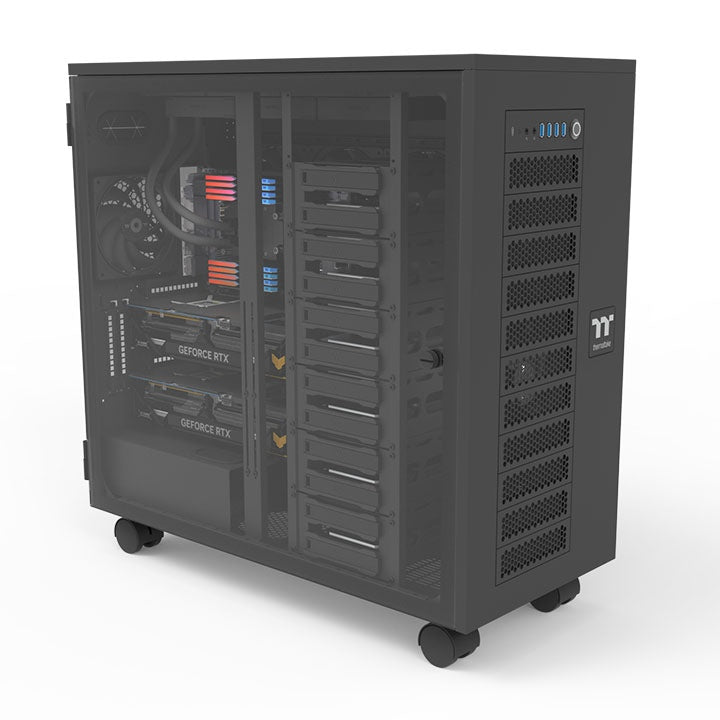
Das Thermaltake AX700 Super Tower Chassis bildet die Basis für leistungsstarke AI Workstations, GPU-Compute-, Rendering- und Enterprise-Workloads. Die Plattform unterstützt Mainboards bis XL-ATX sowie SSI-EEB, bietet 10 Erweiterungsslots und ermöglicht umfangreiche Storage-, Kühlungs- und Erweiterungskonzepte für anspruchsvolle professionelle Systeme.
SSI-EEB / XL-ATXUnterstützung großer Workstation- und Enterprise-Mainboards.
10 Expansion SlotsUmfangreiche Erweiterungsmöglichkeiten für leistungsstarke GPUs und professionelle Zusatzkarten.
Bis 18 DrivesHohe lokale Storage-Kapazität mit bis zu 18 × 2,5"/3,5" HDDs oder SSDs.
High-End Cooling PlatformUnterstützung umfangreicher Luft-, AIO- und Custom-Watercooling-Konfigurationen für dauerhaft hohe Systemlast.
Ideal für professionelle Single-System AI Workstations, lokale LLMs, AI Inference, Machine Learning, Generative AI, GPU Rendering und datenintensive Compute-Workloads.
AX1000. Dual-System-Plattform für skalierbare Enterprise AI Workloads.&nbsp;
AX SERIES · ENTERPRISE DUAL-SYSTEM PLATFORM

AX1000. Dual-System-Plattform für skalierbare Enterprise AI Workloads. 

Das Thermaltake AX1000 Super Tower Chassis ist für besonders anspruchsvolle Dual-System Workstations und Enterprise-Infrastrukturen ausgelegt. Zwei Systemplattformen können innerhalb eines Chassis realisiert werden – mit Unterstützung für bis zu zwei XL-ATX- oder E-ATX-Mainboards, separaten I/O-Sets und umfangreichen Erweiterungs-, Storage- und Kühlungsoptionen.
2 × XL-ATX / SSI-EEBZwei leistungsstarke Systemplattformen in einem Super-Tower-Chassis für getrennte oder parallele Workloads.
10 + 10 Expansion SlotsBis zu 20 Erweiterungsslots für umfangreiche GPU-, Compute-, Storage- und professionelle Erweiterungskonzepte.
Bis zu 24 DrivesSehr hohe lokale Storage-Kapazität für große Datensätze, Modelle, RAG-Datenbanken und Enterprise-Projekte.
Dual-System Cooling ArchitectureUmfangreiche Kühlungsoptionen mit Unterstützung von bis zu 29 × 120-mm- bzw. 140-mm-Lüftern sowie groß dimensionierten AIO- und Custom-Radiator-Konfigurationen.
Ideal für Enterprise AI, parallele Inference- und Development-Workloads, Multi-User-Szenarien, große lokale Datenmengen sowie Projekte, bei denen zwei getrennte Workstation-Umgebungen innerhalb einer Plattform benötigt werden.
AI DEPLOYMENT STRATEGY

Local AI Workstation oder Cloud? Die richtige Architektur für Ihr Unternehmen. 

Lokale AI Workstations und Cloud-Infrastrukturen erfüllen unterschiedliche Anforderungen an Datenschutz, Performance, Skalierbarkeit und Kostenstruktur. Für viele Unternehmen ist eine hybride AI-Architektur die effizienteste Lösung.
Seitlich wischen →
KriteriumLocal AI WorkstationCloud
Datenkontrolle & DatenschutzDaten, Modelle und Workloads können innerhalb der eigenen Infrastruktur verarbeitet und gespeichert werden.eigenen Infrastruktur verarbeitet und gespeichert werden.Verarbeitung und Speicherung hängen von Anbieter, Region, Vertrag und gewählten Services ab.
Compute-VerfügbarkeitDedizierte GPU- und Compute-Ressourcen stehen dem eigenen Team unmittelbar zur Verfügung.Ressourcen werden bedarfsgerecht bereitgestellt und hängen von Service, Region und Kontingent ab.
KostenmodellInvestition in eigene Hardware mit planbaren Betriebs- und Lifecycle-Kosten.Nutzungsabhängige laufende Kosten entsprechend Compute-Zeit, Storage, Traffic und Services.
Hardware-KontrolleGPU, CPU, RAM, Storage, Netzwerk und Plattform können gezielt auf den Workload abgestimmt werden.Hardwareauswahl und Instanztypen richten sich nach dem Angebot des Cloud-Providers.
SkalierbarkeitSkalierung durch Upgrades, zusätzliche Workstations oder lokale Compute-Nodes.Flexible Skalierung über zusätzliche Instanzen, Ressourcen und Managed Services.
Latenz & DatenzugriffDirekter lokaler Zugriff auf Modelle, Daten und Storage ohne externen Datentransfer.Abhängig von Netzwerk, Region, Datenmenge und gewählter Cloud-Architektur.
Die optimale AI-Infrastruktur hängt von Datenschutzanforderungen, Workload, Auslastung, Latenz, Skalierungsbedarf, Kostenmodell und bestehender IT-Infrastruktur ab. Lokale Workstations, Cloud-Ressourcen und hybride Architekturen können dabei gezielt miteinander kombiniert werden.
<strong>Ein System. Ein Spezialist. Eine Verantwortung.</strong>&nbsp;
ENGINEERED & BUILT IN GERMANY

Ein System. Ein Spezialist. Eine Verantwortung. 

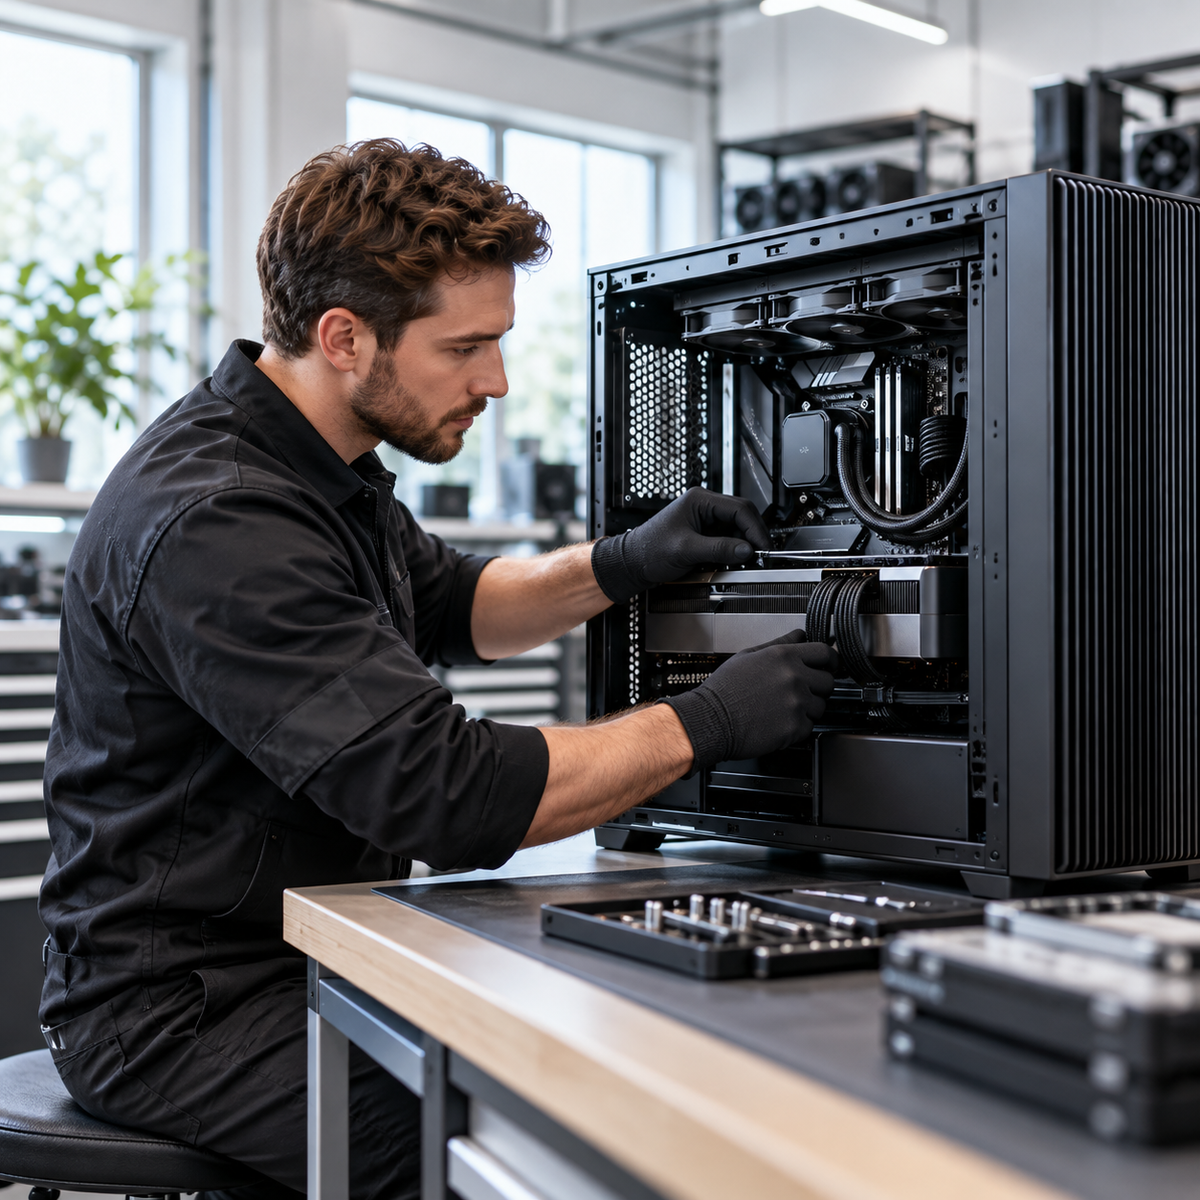
Jede Thermaltake AI Workstation wird von einem spezialisierten Techniker durch den gesamten Build-Prozess begleitet – von der Komponentenprüfung über Montage, Verkabelung und Systemkonfiguration bis zur Validierung und finalen technischen Freigabe.
01
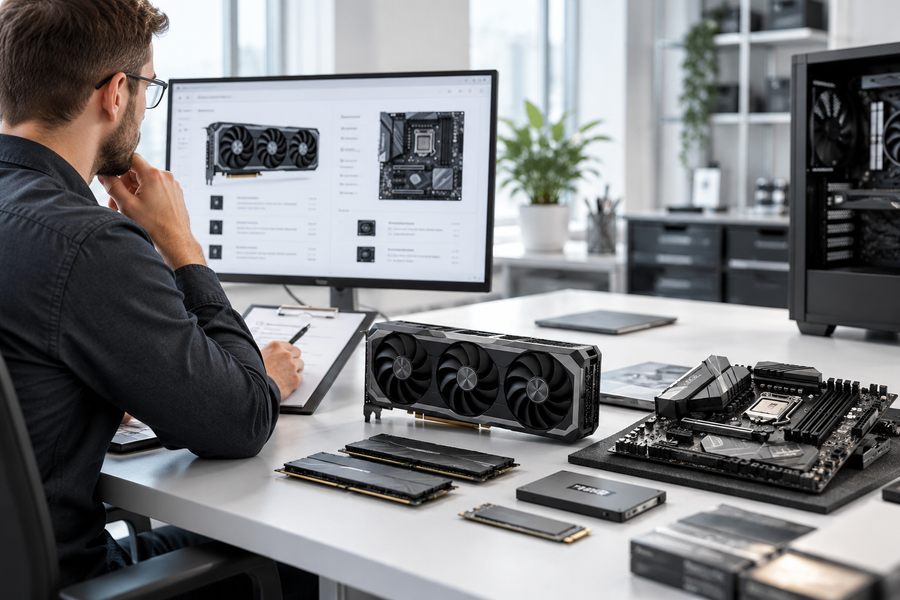
Engineering CheckPlattform, GPU, CPU, RAM, Storage, Stromversorgung und Kühlung werden als Gesamtsystem geprüft.
02
Specialist AssemblyProfessionelle Montage, Verkabelung und Systemintegration mit Fokus auf Stabilität, Airflow und Serviceability.
03
Validation & ReleaseBIOS, Firmware, Treiber, Stabilität, Thermik und Grundfunktion werden vor Auslieferung geprüft und das System erst nach erfolgreicher Validierung freigegeben.
ENGINEERING, BUILD & VALIDATION

Professioneller Workstation-Build. Validiert vor der Auslieferung. 

Qualität ist kein einzelner Check am Ende, sondern ein durchgängiger Prozess über Aufbau, Konfiguration, Test und Freigabe.
Technisches FreigabeprinzipDie Auslieferung erfolgt erst nach erfolgreicher Prüfung von Systemfunktion, Stabilität, Thermik und Grundkonfiguration.
Anforderungen & Komponentencheck
01

Anforderungen & Komponentencheck

Workload, Plattform, GPU, CPU, RAM, Storage, Stromversorgung und Kühlung werden vor dem Aufbau auf technische Kompatibilität und Systemreserven geprüft.

Kompatibilität · Power Delivery · Kühlung · Erweiterbarkeit
Professioneller Systemaufbau
02

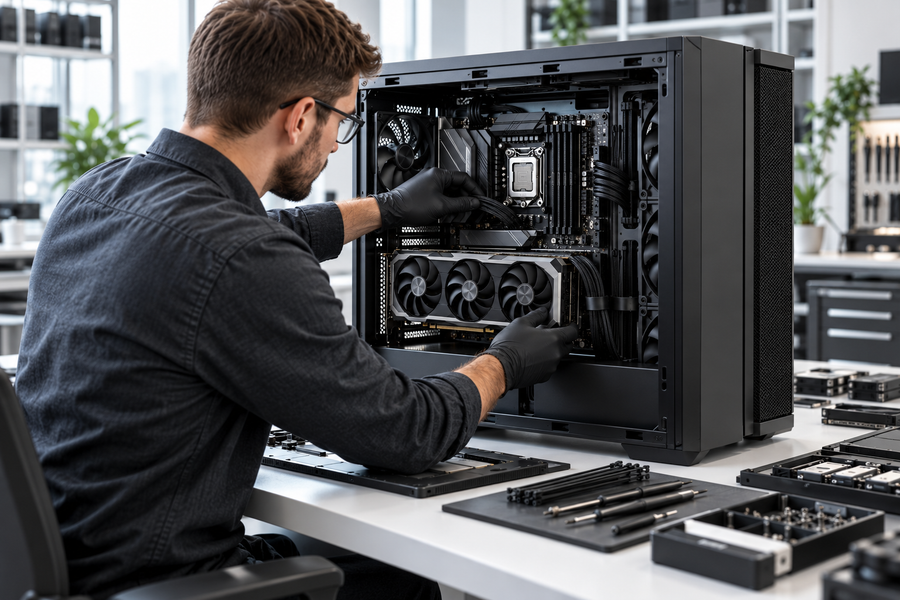
Professioneller Systemaufbau

Mechanischer Aufbau, Verkabelung und Komponentenmontage erfolgen mit Fokus auf Airflow, Serviceability, Stabilität und saubere Systemintegration.

Assembly · Cable Management · Airflow · Serviceability
BIOS, Firmware & Systembasis
03

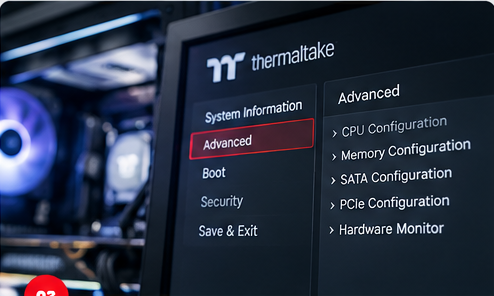
BIOS, Firmware & Systembasis

BIOS, Firmware, Speicherprofile, Lüftersteuerung und grundlegende Systemparameter werden passend zur Plattform konfiguriert.

BIOS · Firmware · Memory · Cooling Control
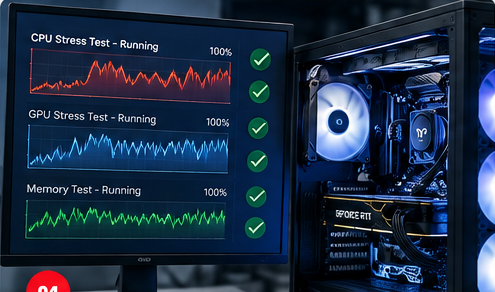
Stabilitäts- & Belastungstests
04

Stabilitäts- & Belastungstests

CPU, GPU, Arbeitsspeicher und Systembasis werden unter Last geprüft, um Stabilität und zuverlässige Grundfunktion zu validieren.

CPU Load · GPU Load · Memory · System Stability
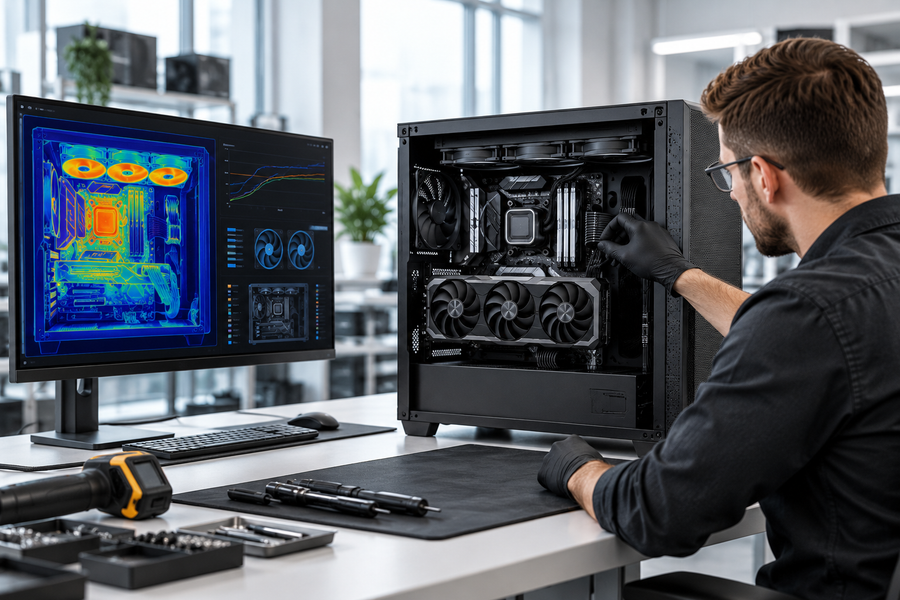
Thermik & finale Qualitätskontrolle
05

Thermik & finale Qualitätskontrolle

Temperaturen, Lüfterverhalten, Verkabelung, Komponentenstatus und Gesamtzustand werden vor der Freigabe final kontrolliert.

Thermal Validation · Visual Inspection · Final Check
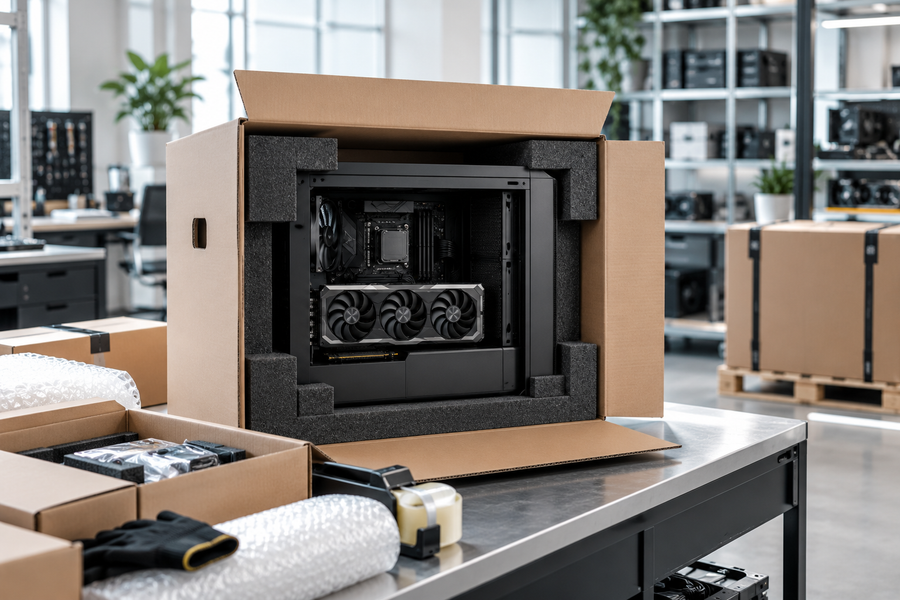
Freigabe & sichere Auslieferung
06

Freigabe & sichere Auslieferung

Nach erfolgreicher Validierung wird die Workstation final freigegeben, transportsicher verpackt und für die Auslieferung vorbereitet.

Release · Packaging · Delivery Preparation
Professionelle AI Workstations – in Deutschland konfiguriert, montiert und validiert.Jede Thermaltake AI Workstation durchläuft einen definierten Engineering-, Build- und Quality-Validation-Prozess – von der Komponentenprüfung bis zur finalen technischen Freigabe.
QUALITY VALIDATED
Workstation Services

Professionelle Services für AI Workstations & Enterprise-Systeme. 

Neben dem Hardware-Build übernehmen wir die technische Systemkonfiguration, Validierung und projektbezogene Vorbereitung Ihrer AI Workstation. So entsteht eine produktionsbereite Plattform, abgestimmt auf Workload, Software-Stack, Performance- und Infrastruktur-Anforderungen.
System ConfigurationBIOS, Firmware und zentrale Systemparameter werden passend zu Plattform, Workload und eingesetzter Hardware konfiguriert.
OS & Driver SetupBetriebssystem, Treiber und Systembasis werden entsprechend dem abgestimmten Projekt- und Software-Stack vorbereitet.
Memory & StorageRAM- und NVMe-Storage-Konfiguration werden auf Datenvolumen, Modelle, Cache, I/O-Anforderungen und Workload abgestimmt.
Stress / Burn-inCPU, GPU, Arbeitsspeicher und Systembasis werden unter Last auf Stabilität, Performance und zuverlässige Grundfunktion geprüft.
Thermal ValidationTemperaturen, Lüfterverhalten, Airflow und Kühlleistung werden unter realistischen Lastbedingungen kontrolliert und validiert.
Custom ProjectsIndividuelle Lösungen für Multi-GPU-Systeme, besondere Storage- und Netzwerkarchitekturen, Software-Anforderungen sowie Enterprise-Rollouts.
SOFTWARE, FRAMEWORKS & AI TOOLING

AI Workstations für professionelle Software-Stacks und produktive Workflows. 

Betriebssystem, Treiber, GPU-Architektur, CUDA-Umgebung, Arbeitsspeicher, Storage und AI-Toolchain werden gemeinsam auf den jeweiligen Workload abgestimmt. So entsteht eine professionelle AI Workstation für Entwicklung, Inference, Machine Learning, Generative AI, Rendering und lokale KI-Anwendungen.
Genannte Software-, Framework- und Markennamen beschreiben typische Einsatzszenarien und Workloads. Sie stellen keine Zertifizierung, Partnerschaft oder garantierte Kompatibilität dar; die konkrete Systemauslegung erfolgt abhängig von Software-Version, Betriebssystem, Treibern und Hardware-Konfiguration.
AI Frameworks
PyTorchTensorFlowJAXAnaconda
GPU & Runtime
NVIDIA CUDAPythonDockerWSL2
Local AI
OllamaLM Studiollama.cppOpen WebUI
Generative AI
ComfyUIStable DiffusionDiffusers
Content & Render
BlenderGPU RenderingDaVinci Resolve
OS & Virtualization
WindowsUbuntuLinuxVirtualization
FAQ

Technische Fragen vor der Konfiguration.

Die passende Workstation hängt vom konkreten Modell, Datensatz, Parallelitätsbedarf und Software-Stack ab.
Wie viel VRAM benötigt eine AI Workstation?
Der benötigte GPU-Speicher hängt vor allem von Modellgröße, Quantisierung, Kontextlänge, Batch Size und der Anzahl paralleler Workloads ab. Bei lokalen LLMs und generativer AI ist VRAM häufig einer der entscheidenden Faktoren. Die Systemauslegung sollte deshalb immer auf Basis des tatsächlich eingesetzten Modells und Software-Stacks erfolgen.
Wann benötige ich mehr als eine GPU?
Mehrere GPUs können sinnvoll sein, wenn Modelle oder Workloads mehr GPU-Ressourcen benötigen, als eine einzelne GPU bereitstellen kann, oder wenn mehrere AI-, Rendering- oder Compute-Prozesse parallel betrieben werden sollen. Ob ein Workload tatsächlich über mehrere GPUs skaliert, hängt jedoch von Framework, Software und Modellarchitektur ab.
Wie viel RAM sollte eine professionelle AI Workstation haben?
Der benötigte System-RAM hängt von Modellgröße, Dataset, Preprocessing, parallelen Anwendungen und dem Verhältnis zwischen System-RAM und GPU-VRAM ab. Für professionelle AI-Workloads sind hohe Speicherkapazitäten häufig sinnvoll. Thermaltake Workstations können je nach Plattform mit entsprechend großen RAM-Konfigurationen ausgelegt werden.
Windows oder Linux für eine AI Workstation?
Beide Betriebssysteme können für professionelle AI-Workloads geeignet sein. Linux bietet eine sehr breite Unterstützung für AI-Frameworks, Container und Entwicklungsumgebungen. Windows eignet sich unter anderem für kombinierte AI-, Engineering- und Content-Creation-Workflows und kann über WSL2 zusätzliche Linux-basierte Entwicklungsumgebungen bereitstellen. Entscheidend sind Software-Stack, Treiber und vorhandene IT-Infrastruktur.
Kann eine AI Workstation später erweitert werden?
Ja, sofern Erweiterbarkeit bereits bei der ursprünglichen Systemauslegung berücksichtigt wird. Mainboard, Netzteil, Kühlung, Gehäuse, PCIe-Slots, RAM-Kapazität und Storage sollten genügend Reserven für spätere Upgrades bieten. Genau deshalb betrachten wir die Workstation als Gesamtsystem und nicht nur als aktuelle Komponentenliste.
AX700 oder AX1000 – welche Plattform ist die richtige?
Das AX700 eignet sich für eine leistungsstarke Single-System AI Workstation mit umfangreichen Erweiterungs-, Storage- und Kühlmöglichkeiten. Das AX1000 ist für zwei voneinander unabhängige Workstation-Systeme innerhalb eines Chassis ausgelegt und eignet sich damit für parallele AI-, Compute-, Rendering- oder Produktions-Workloads. Welche Plattform sinnvoller ist, hängt von Workload, Erweiterungsbedarf und Infrastrukturkonzept ab.
Was ist der Vorteil einer lokalen AI Workstation gegenüber Cloud Computing?
Eine lokale AI Workstation stellt dedizierte Compute-Ressourcen innerhalb der eigenen Infrastruktur bereit. Daten, Modelle und Workloads können lokal verarbeitet werden, und die Hardware steht ohne nutzungsabhängige Compute-Abrechnung zur Verfügung. Cloud-Ressourcen bieten dagegen hohe Flexibilität und schnelle Skalierbarkeit. Für viele Unternehmen kann eine Kombination aus lokaler AI Workstation und Cloud-Ressourcen sinnvoll sein.
Welche Rolle spielt NVMe-Storage bei AI-Workloads?
Schneller NVMe-Storage kann insbesondere bei großen Modellen, Datensätzen, RAG-Datenbanken, Checkpoints, Cache-Dateien sowie Bild- und Videodaten wichtig sein. Neben der reinen Kapazität sollten deshalb auch I/O-Leistung, Datenorganisation und zukünftiger Storage-Bedarf berücksichtigt werden.
Wie wichtig ist die CPU bei einer AI Workstation?
Auch wenn viele AI-Workloads primär GPU-beschleunigt sind, bleibt die CPU ein wichtiger Bestandteil des Gesamtsystems. Sie übernimmt unter anderem Datenvorbereitung, Preprocessing, Compiling, allgemeine Systemaufgaben und CPU-basierte Workloads. Die CPU sollte deshalb passend zu GPU-Konfiguration, Dataset und Software-Stack dimensioniert werden.
Wie werden Kühlung und Stromversorgung einer AI Workstation dimensioniert?
Leistungsstarke GPUs und CPUs können unter Dauerlast hohe Anforderungen an Stromversorgung und Kühlung stellen. Netzteil, Airflow, Kühllösung und Gehäuse müssen deshalb auf die maximale Systemlast und den vorgesehenen Dauerbetrieb abgestimmt werden. Thermische Reserven sind insbesondere bei professionellen AI-, Rendering- und Compute-Workloads wichtig.
Welche AI-Software und Frameworks können eingesetzt werden?
Typische Workloads umfassen unter anderem PyTorch, TensorFlow, JAX, NVIDIA CUDA, Python, Docker, Ollama, LM Studio, llama.cpp, Open WebUI, ComfyUI und Stable Diffusion. Die konkrete Kompatibilität hängt von Betriebssystem, Software-Version, Treibern, GPU und Hardware-Konfiguration ab und sollte vor der finalen Systemauslegung geprüft werden.
Eignet sich eine GeForce RTX 5090 für lokale AI-Workloads?
Eine RTX 5090 mit 32 GB GPU-Speicher kann für zahlreiche lokale LLM-, Inference-, Generative-AI-, Machine-Learning- und Rendering-Workloads eine leistungsfähige Plattform darstellen. Ob 32 GB VRAM ausreichen, hängt jedoch vom eingesetzten Modell, der Quantisierung, Kontextlänge und Parallelität ab.
Kann eine AI Workstation auch für mehrere Workloads genutzt werden?
Ja. Eine entsprechend dimensionierte Workstation kann beispielsweise lokale LLMs, RAG, Machine Learning, Computer Vision, Generative AI und Rendering auf derselben Plattform unterstützen. Entscheidend ist, dass GPU, CPU, RAM, Storage und Software-Stack gemeinsam auf die vorgesehenen Anwendungen abgestimmt werden.
Können individuelle Sonderkonfigurationen umgesetzt werden?
Ja. Anforderungen wie Multi-GPU-Systeme, große RAM-Konfigurationen, spezielle Storage- oder Netzwerkarchitekturen, besondere Software-Stacks oder größere B2B-Rollouts können über eine individuelle Projektanfrage geprüft werden. Die technische Machbarkeit und Systemauslegung werden vor der Fertigung abgestimmt.
Wie wird eine Thermaltake AI Workstation vor der Auslieferung geprüft?
Die Workstation durchläuft einen definierten Build- und Validierungsprozess. Dazu gehören Komponentenprüfung, professioneller Aufbau, BIOS- und Firmware-Konfiguration sowie Stabilitäts-, Belastungs- und Thermikprüfungen. Die technische Freigabe erfolgt erst nach Abschluss der vorgesehenen Prüfungen.
Brauche ich für eine AI Workstation eine professionelle GPU oder reicht eine GeForce RTX 5090?
Das hängt vom konkreten Workload ab. Eine GeForce RTX 5090 kann mit hoher GPU-Leistung und 32 GB VRAM für viele lokale LLM-, Inference-, Generative-AI-, Machine-Learning- und Rendering-Workloads eine leistungsfähige Lösung sein. Professionelle GPUs können dagegen Vorteile bei höherem VRAM-Bedarf, speziellen Treiberanforderungen, zertifizierten Anwendungen, Multi-GPU-Szenarien oder langfristig standardisierten Enterprise-Deployments bieten. Die geeignete GPU sollte deshalb anhand von Modellgröße, Software-Stack, VRAM-Bedarf, Stabilitätsanforderungen und geplanter Nutzung ausgewählt werden.
ENTERPRISE AI PROJECTS & CUSTOM WORKSTATIONS

Individuelle AI Workstations für komplexe Enterprise-Anforderungen. 

Wenn Ihre Anforderungen über den Standard-Konfigurator hinausgehen, entwickeln wir gemeinsam mit Ihnen eine maßgeschneiderte Workstation-Lösung. Unsere Spezialisten unterstützen Sie bei Multi-GPU-Systemen, speziellen Storage- und Netzwerkarchitekturen, individuellen Software-Stacks sowie größeren B2B- und Rollout-Projekten.
Multi-GPU WorkstationsEnterprise Storage & NetworkingCustom Software & AI StacksB2B Rollouts & Multi-System Projects
Projekt anfragen
Ihre Anforderungen. Unsere technische Auslegung.

Wenn Standard nicht reicht, wird es Ihr Projekt.

Beschreiben Sie kurz Ihren AI-Workload, die gewünschte Plattform und besondere technische Anforderungen. Unsere Workstation-Spezialisten prüfen Ihr Projekt und melden sich mit einer passenden Systemempfehlung und den nächsten Schritten zurück. ✓ Technische Prüfung durch unser Workstation-Team ✓ Individuelle Auslegung für AI-, GPU- und Compute-Workloads ✓ Kompatibilitäts- und Systemprüfung vor Fertigung ✓ Unterstützung bei Einzelprojekten, Rollouts und Sonderkonfigurationen