
Local LLM & RAG
Lokale Sprachmodelle, Retrieval-Augmented Generation und datensensible AI-Workflows mit dedizierter GPU-Leistung, hoher Speicherkapazität und schnellen lokalen Datenpfaden.
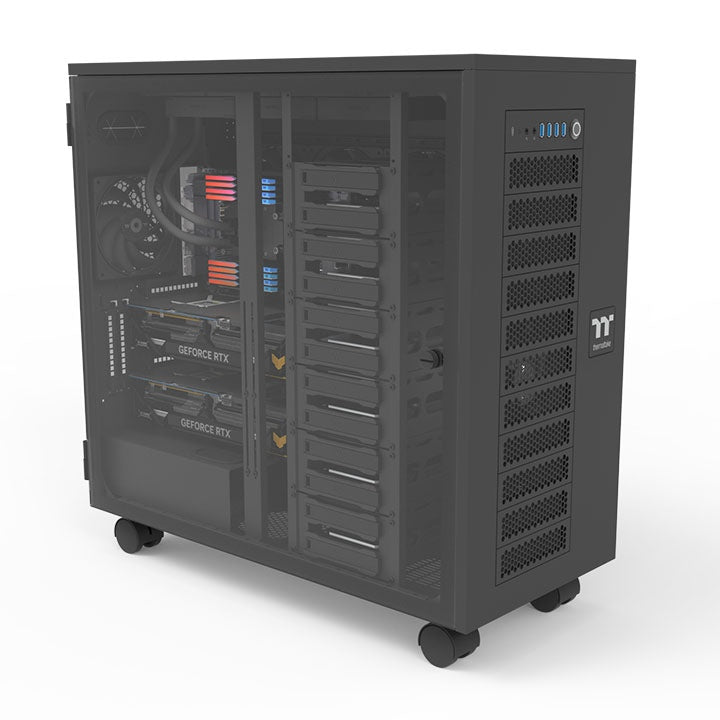
Lokale Sprachmodelle, Retrieval-Augmented Generation und datensensible AI-Workflows mit dedizierter GPU-Leistung, hoher Speicherkapazität und schnellen lokalen Datenpfaden.

Leistungsstarke GPU-Workstations für Bild-, Video- und Content-Generierung mit Stable-Diffusion-, ComfyUI- und weiteren generativen AI-Workflows.

Dedizierte Compute-Ressourcen für reproduzierbare, skalierbare und dauerhaft verfügbare Inference-Workloads mit kontrollierbarer Latenz und Performance.

Professionelle Plattformen für Entwicklung, Training, Fine-Tuning, Data Processing und experimentelle Machine-Learning-Workloads.

GPU-beschleunigte Workstations für Bildanalyse, Videoanalyse, Preprocessing, Objekterkennung und lokale Modellinferenz.

High-Performance GPU-Workstations für 3D-Rendering, Simulation, Visualisierung, Content Creation und GPU-beschleunigte Produktions-Workflows.
Local LLM & RAG
AI Inference
CAD & 3D Rendering
Content Creation
Machine Learning & Deep Learning
Generative AI
größere RAG-Datenbanken
parallele GPU-Workloads
Enterprise AI
große Datensätze
Multi-Workload-Umgebungen
anspruchsvolle B2B-Projekte
| AI Workload | GPU & VRAM | System-RAM & STORAGE | Engineering Focus |
|---|---|---|---|
| Local LLM / RAG | VRAM häufig entscheidender Faktor bei Modellgröße, Quantisierung und Kontextlänge. | Abhängig von Modell, Vektordatenbank, Dokumentbestand und parallelen Sessions. | Kontextlänge, Quantisierung, Embeddings, RAG-Datenbasis und gleichzeitige Nutzer berücksichtigen. |
| AI Inference | Dimensionierung nach Modellgröße, Batch Size, Durchsatz und gewünschter Latenz. | Abhängig von Modell, Serving-Stack und parallelen Instanzen. | Latenz, Tokens pro Sekunde, parallele Nutzer und dauerhafte Verfügbarkeit gemeinsam planen. |
| Machine Learning & Deep Learning | Abhängig von Modellarchitektur, Dataset, Training, Fine-Tuning und Framework. | Reserve für Preprocessing, Dataset Caching und parallele Entwicklungsumgebungen einplanen. | Datenpipeline, Framework, Trainingstyp, Precision und GPU-Auslastung als Gesamtsystem betrachten. |
| 3D Rendering & Content Creation | Abhängig von Szenengröße, Auflösung, Renderer und parallelen Produktions-Workloads. | Projektgröße, Cache, Assets und Storage-Durchsatz berücksichtigen. | GPU, CPU, Arbeitsspeicher, Cache und NVMe-Storage gemeinsam dimensionieren. |
| Computer Vision | Abhängig von Auflösung, Modellgröße, Batch Size und Video-Streams. | Hoher Datenbedarf bei Bild- und Videoanalyse möglich. | Preprocessing, Inference, Kamera-Streams und Datenpipeline gemeinsam planen. |
| Generative AI | Hoher VRAM-Bedarf je nach Modell, Auflösung und Anzahl paralleler Generierungen. | Ausreichende Kapazität für Modelle, Checkpoints, LoRAs, Cache und Projektdaten. | Stable Diffusion, ComfyUI, Video-Generierung und lokale Modellverwaltung berücksichtigen. |
| Kriterium | Local AI Workstation | Cloud |
|---|---|---|
| Datenkontrolle & Datenschutz | Daten, Modelle und Workloads können innerhalb der eigenen Infrastruktur verarbeitet und gespeichert werden. | eigenen Infrastruktur verarbeitet und gespeichert werden.Verarbeitung und Speicherung hängen von Anbieter, Region, Vertrag und gewählten Services ab. |
| Compute-Verfügbarkeit | Dedizierte GPU- und Compute-Ressourcen stehen dem eigenen Team unmittelbar zur Verfügung. | Ressourcen werden bedarfsgerecht bereitgestellt und hängen von Service, Region und Kontingent ab. |
| Kostenmodell | Investition in eigene Hardware mit planbaren Betriebs- und Lifecycle-Kosten. | Nutzungsabhängige laufende Kosten entsprechend Compute-Zeit, Storage, Traffic und Services. |
| Hardware-Kontrolle | GPU, CPU, RAM, Storage, Netzwerk und Plattform können gezielt auf den Workload abgestimmt werden. | Hardwareauswahl und Instanztypen richten sich nach dem Angebot des Cloud-Providers. |
| Skalierbarkeit | Skalierung durch Upgrades, zusätzliche Workstations oder lokale Compute-Nodes. | Flexible Skalierung über zusätzliche Instanzen, Ressourcen und Managed Services. |
| Latenz & Datenzugriff | Direkter lokaler Zugriff auf Modelle, Daten und Storage ohne externen Datentransfer. | Abhängig von Netzwerk, Region, Datenmenge und gewählter Cloud-Architektur. |
Workload, Plattform, GPU, CPU, RAM, Storage, Stromversorgung und Kühlung werden vor dem Aufbau auf technische Kompatibilität und Systemreserven geprüft.
Kompatibilität · Power Delivery · Kühlung · Erweiterbarkeit
Mechanischer Aufbau, Verkabelung und Komponentenmontage erfolgen mit Fokus auf Airflow, Serviceability, Stabilität und saubere Systemintegration.
Assembly · Cable Management · Airflow · Serviceability
BIOS, Firmware, Speicherprofile, Lüftersteuerung und grundlegende Systemparameter werden passend zur Plattform konfiguriert.
BIOS · Firmware · Memory · Cooling Control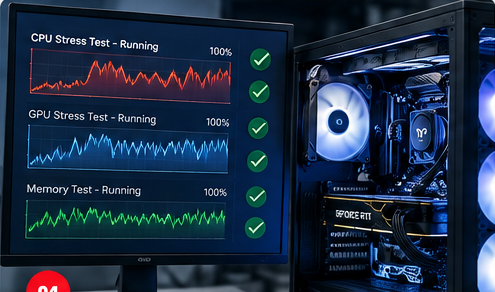
CPU, GPU, Arbeitsspeicher und Systembasis werden unter Last geprüft, um Stabilität und zuverlässige Grundfunktion zu validieren.
CPU Load · GPU Load · Memory · System Stability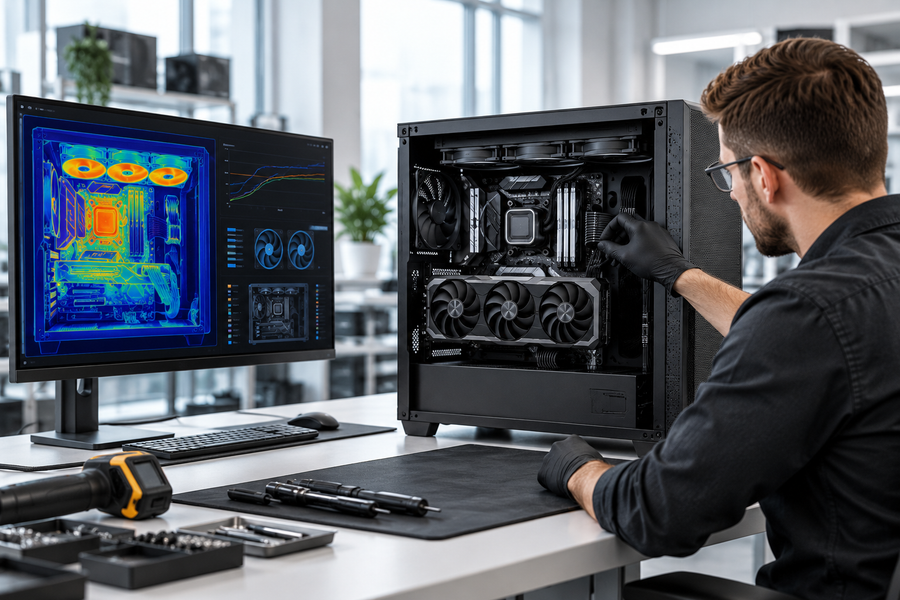
Temperaturen, Lüfterverhalten, Verkabelung, Komponentenstatus und Gesamtzustand werden vor der Freigabe final kontrolliert.
Thermal Validation · Visual Inspection · Final Check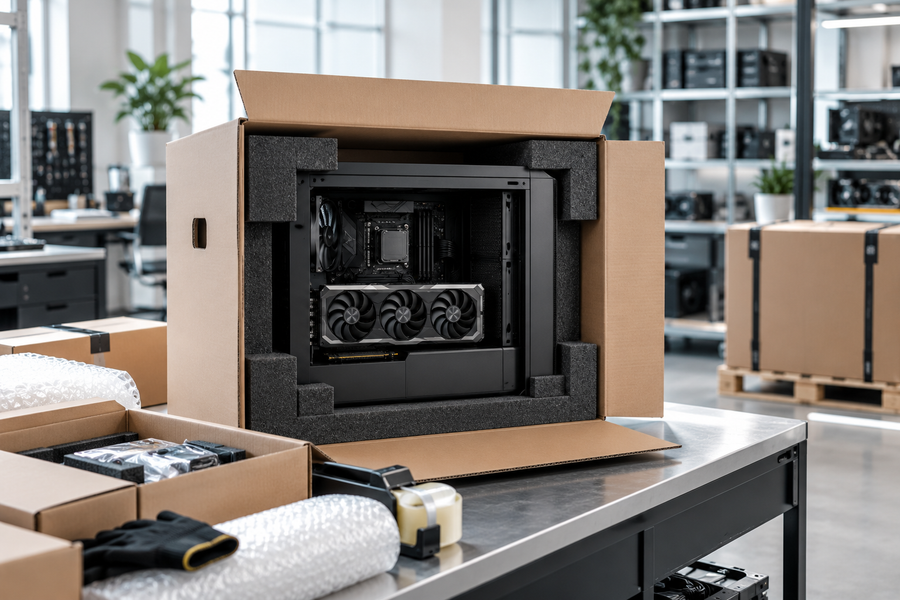
Nach erfolgreicher Validierung wird die Workstation final freigegeben, transportsicher verpackt und für die Auslieferung vorbereitet.
Release · Packaging · Delivery Preparation